Lab 3 — La mémoire : caches, copies et partage
Les Labs 1 et 2 ont réparti du calcul. Ce lab regarde les données : comment le processeur les lit (par lignes de cache de 64 octets, Séance 1 et Séance 2), ce que chaque processus reçoit (une copie), ce qui se passe quand plusieurs processus écrivent dans la même mémoire (des incréments perdus), et comment partager un grand tableau sans le copier, chaque processus travaillant sur sa part (l’idée du placement des données de la Séance 4).
Prérequis : Labs 0 à 2. Durée estimée : 1 h 30.
Les blocs sans titre sont des commandes à taper dans le terminal (Anaconda Prompt) ; les blocs titrés « Cellule » sont le contenu des cellules du notebook, numérotées dans l’ordre ; les blocs titrés « Résultat » montrent le résultat obtenu (les durées et les numéros de processus changent d’une machine à l’autre). Pour copier un bloc : cliquer sur l’icône de copie, en haut à droite du bloc, puis le coller dans la cellule ; l’indentation est conservée. Le notebook complet est aussi à télécharger (panneau « Pour cette séance » de cette page).
Partie 0 — Mise en place
Cellule 1
import numpy as np
from multiprocessing import shared_memory

def ajouter_et_compter(liste):
    liste.append(999)                    # modifie la liste REÇUE par le processus
    return len(liste)

def somme_copie(tableau):
    return float(tableau.sum())          # le tableau a été copié vers le processus

def incrementer_sans_verrou(compteur, n):
    for _ in range(n):
        compteur.value += 1              # lire, ajouter, écrire : sans protection

def incrementer_avec_verrou(compteur, n):
    for _ in range(n):
        with compteur.get_lock():        # un seul processus à la fois
            compteur.value += 1

def histo_partage(ages, hist):
    for a in ages:
        with hist.get_lock():
            hist[a // 10] += 1           # une écriture partagée par patient

def histo_local(ages):
    return np.bincount(np.asarray(ages) // 10, minlength=9)   # histogramme privé

def somme_partagee(nom, taille, debut, fin):
    shm = shared_memory.SharedMemory(name=nom)           # s'attacher au tableau partagé
    a = np.ndarray((taille,), dtype=np.float64, buffer=shm.buf)
    s = float(a[debut:fin].sum())                         # lire SA part, sans copie
    del a
    shm.close()
    return s
Résultat →
Writing outils_lab3.pyCellule 2
import os, time
import numpy as np
import pandas as pd
import multiprocessing as mp
from multiprocessing import shared_memory
import matplotlib.pyplot as plt
import outils_lab3 as o3

def chrono(f, *args, repetitions=3):
    """exécute f(*args) plusieurs fois et rend la durée la plus courte, en secondes"""
    meilleure = float("inf")
    for _ in range(repetitions):
        t0 = time.perf_counter()
        f(*args)
        meilleure = min(meilleure, time.perf_counter() - t0)
    return meilleure

print("coeurs :", os.cpu_count())
Résultat →
coeurs : 2Partie 1 — Les caches, vus depuis NumPy
Le processeur ne lit jamais un nombre seul : il charge une ligne de cache de \(64\) octets, soit \(8\) nombres float64 voisins en mémoire (Séance 1). Un programme qui lit des nombres voisins profite de toute la ligne ; un programme qui saute d’un endroit à l’autre en gaspille l’essentiel.
1.1 Lire dans l’ordre ou au hasard
On lit les mêmes \(8\) millions de nombres d’un tableau, une fois dans l’ordre, une fois dans un ordre mélangé. Le travail est identique : seul l’ordre des lectures change.
Cellule 3
N = 2**23                                       # 8 millions de float64 = 64 Mo
x = np.ones(N)
dans_l_ordre = np.arange(N)
au_hasard = np.random.default_rng(221).permutation(N)   # les mêmes indices, mélangés

print(f"dans l'ordre : {chrono(lambda: x[dans_l_ordre].sum()):.4f} s")
print(f"au hasard    : {chrono(lambda: x[au_hasard].sum()):.4f} s")
Résultat →
dans l'ordre : 0.0339 s
au hasard : 0.0932 sLire au hasard est nettement plus lent. Dans l’ordre, chaque ligne de cache chargée sert à \(8\) nombres consécutifs, et le processeur devine les lignes suivantes et les charge d’avance. Au hasard, presque chaque nombre demande sa propre ligne, venue de la mémoire principale.
1.2 Lire un nombre sur \(k\)
On additionne un nombre sur \(k\) d’un grand tableau. Avec \(k\) plus grand, on lit \(k\) fois moins de nombres : va-t-on \(k\) fois plus vite ?
Cellule 4
x = np.ones(2**24)                     # 16 millions de float64 = 128 Mo
K = [1, 2, 4, 8, 16, 32]
print(" k   nombres lus   durée (ms)   ns par nombre")
cout = []
for k in K:
    v = x[::k]                                           # un nombre sur k
    t = chrono(np.sum, v)
    cout.append(t / len(v) * 1e9)
    print(f"{k:2d}   {len(v):11d}   {t * 1e3:10.2f}   {cout[-1]:13.2f}")
Résultat →
 k   nombres lus   durée (ms)   ns par nombre
 1      16777216        15.46            0.92
 2       8388608        10.96            1.31
 4       4194304         8.35            1.99
 8       2097152         7.29            3.47
16       1048576         6.44            6.15
32        524288         3.40            6.49
Cellule 5
plt.figure(figsize=(5.5, 3.3))
plt.plot(K, cout, "o-")
plt.axvline(8, ls=":", color="gray")
plt.xscale("log", base=2); plt.xticks(K, [str(k) for k in K])
plt.xlabel("pas k (un nombre lu sur k)"); plt.ylabel("durée par nombre lu (ns)")
plt.title("Au-delà de k = 8, chaque nombre lu coûte une ligne de cache"); plt.show()
Résultat →
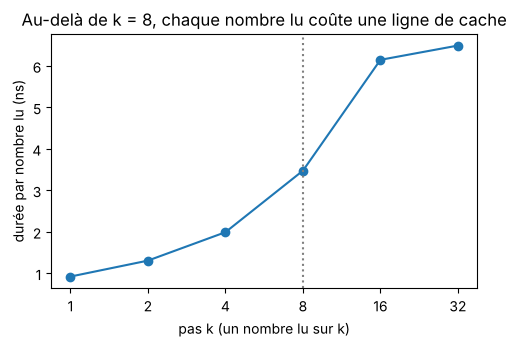
Lire \(8\) fois moins de nombres (\(k=8\)) ne va pas \(8\) fois plus vite : le coût de chaque nombre lu augmente. Jusqu’à \(k=8\), on charge toujours les mêmes lignes de cache (une ligne contient \(8\) nombres) ; on paie la ligne entière pour n’en garder qu’une partie. Au-delà, chaque nombre lu demande sa propre ligne de cache : on lit beaucoup moins de nombres, mais chacun coûte plusieurs fois plus cher qu’à \(k=1\).
Refaire la mesure 1.1 avec un petit tableau de \(2^{17}\) nombres (\(1\) Mo), qui tient dans le cache. L’écart entre « dans l’ordre » et « au hasard » est-il le même ?
Cellule 6 — à compléter
# N = 2**17 ; ...Partie 2 — Chaque processus travaille sur une copie
Ce qu’on envoie à un processus est copié : il reçoit ses propres données, et ce qu’il y change ne revient pas dans le notebook (Lab 0, section 8.3).
Cellule 7
liste = [1, 2, 3]
with mp.Pool(2) as pool:
    longueurs = pool.map(o3.ajouter_et_compter, [liste, liste])
print("longueurs vues par les processus :", longueurs)
print("liste dans le notebook             :", liste)
Résultat →
longueurs vues par les processus : [4, 4]
liste dans le notebook : [1, 2, 3]Chaque processus a ajouté \(999\) à sa copie (longueur \(4\)) ; la liste du notebook n’a pas changé. Cette séparation protège les processus les uns des autres, mais elle a un prix : copier.
Cellule 8
grand = np.ones(10_000_000)                              # 80 Mo
t_local = chrono(grand.sum)
with mp.Pool(2) as pool:
    t_copie = chrono(lambda: pool.map(o3.somme_copie, [grand, grand]), repetitions=2)
print(f"somme dans le notebook               : {t_local:.4f} s")
print(f"2 processus, chacun reçoit une copie : {t_copie:.4f} s")
Résultat →
somme dans le notebook               : 0.0091 s
2 processus, chacun reçoit une copie : 0.4691 sLa somme elle-même prend quelques millisecondes ; l’envoi de deux copies de \(80\) Mo prend bien plus longtemps. Envoyer de grosses données à des processus peut coûter plus que le calcul : c’est la granularité du Lab 2, appliquée aux données. La Partie 5 montre comment éviter la copie.
Partie 3 — Écrire à plusieurs dans la même mémoire
mp.Value("i", 0) crée un entier en mémoire partagée : tous les processus voient et modifient le même. Deux processus l’incrémentent \(100\,000\) fois chacun. On utilise ici mp.Process, qui lance un processus sur une fonction avec ses arguments ; start le démarre, join attend sa fin.
Cellule 9
def lancer_deux(fonction, compteur, n):
    procs = [mp.Process(target=fonction, args=(compteur, n)) for _ in range(2)]
    for p in procs: p.start()
    for p in procs: p.join()

for essai in range(3):
    compteur = mp.Value("i", 0)
    lancer_deux(o3.incrementer_sans_verrou, compteur, 100_000)
    print(f"essai {essai} : attendu 200000, obtenu {compteur.value}")
Résultat →
essai 0 : attendu 200000, obtenu 132544
essai 1 : attendu 200000, obtenu 117167
essai 2 : attendu 200000, obtenu 142398Des incréments sont perdus, et le résultat change d’un essai à l’autre. compteur.value += 1 se fait en trois temps : lire, ajouter, écrire. Les deux processus s’exécutent vraiment en même temps sur deux cœurs : souvent, les deux lisent la même valeur, et l’une des deux écritures écrase l’autre. C’est une course critique (Séance 3).
Cellule 10
compteur = mp.Value("i", 0)
t0 = time.perf_counter()
lancer_deux(o3.incrementer_avec_verrou, compteur, 100_000)
print(f"avec verrou : obtenu {compteur.value} en {time.perf_counter() - t0:.2f} s")
Résultat →
avec verrou : obtenu 200000 en 1.13 sAvec le verrou (get_lock()), un seul processus à la fois lit et écrit : le compte est exact. Mais chaque incrément prend et rend un verrou, et le compteur passe sans cesse d’un cœur à l’autre (la ligne de cache qui voyage, Séance 2) : c’est beaucoup plus lent qu’un compteur privé.
Partie 4 — Partager peu, fusionner à la fin : l’histogramme des âges
On veut l’histogramme des âges de DataSANTÉ-221 par tranches de dix ans (\(0\)–\(9\), \(10\)–\(19\), …, \(80\)–\(89\)), calculé par deux processus. Version partagée : un tableau de \(9\) cases en mémoire partagée, que chaque processus incrémente pour chacun de ses patients. Version locale : chaque processus calcule son propre histogramme, et le notebook additionne les deux.
Cellule 11
# Ne pas modifier cette cellule : générateur officiel DataSANTÉ-221
def generate_datasante221(n=10_000, seed=221):
    rng = np.random.default_rng(seed)
    age = np.clip(rng.gamma(2.5, 14, n), 5, 85).round(0).astype(int)
    glycemie = np.clip(rng.normal(5.5 + 0.05*age, 1.8), 3.0, 18.0).round(1)
    hemoglobine = np.clip(rng.normal(12.5 - 0.02*age, 1.5), 6.0, 17.0).round(1)
    fievre = np.clip(rng.normal(37.5, 0.9, n), 36.0, 41.5).round(1)
    saison = rng.choice([0, 1], size=n, p=[0.55, 0.45])
    duree = (1.0 + 0.05*age + 0.6*glycemie - 0.3*hemoglobine
             + 1.5*saison + rng.normal(0, 1.8, n)).clip(0.5, 30).round(1)
    proba_palu = 1/(1+np.exp(-(-3 + 1.5*saison + 0.8*(fievre>38.5))))
    palu = (rng.uniform(0,1,n) < proba_palu).astype(int)
    return pd.DataFrame({'age':age,'glycemie':glycemie,'hemoglobine':hemoglobine,
                         'fievre':fievre,'saison':saison,
                         'duree_hospit_j':duree,'paludisme':palu})

df = generate_datasante221()
print("DataSANTÉ-221 :", df.shape)
Résultat →
DataSANTÉ-221 : (10000, 7)Cellule 12
ages = df["age"].tolist() * 10          # 100 000 âges (le jeu répété 10 fois)
moitie = len(ages) // 2

# version partagée : 9 cases communes, une écriture sous verrou par patient
hist = mp.Array("i", 9)
t0 = time.perf_counter()
procs = [mp.Process(target=o3.histo_partage, args=(part, hist))
         for part in (ages[:moitie], ages[moitie:])]
for p in procs: p.start()
for p in procs: p.join()
t_partage = time.perf_counter() - t0
print("partagée :", list(hist), f"  {t_partage:.2f} s")
Résultat →
partagée : [7170, 20090, 20790, 17350, 12590, 8450, 5920, 3280, 4360] 0.78 sCellule 13
# version locale : un histogramme privé par processus, puis une seule addition
t0 = time.perf_counter()
with mp.Pool(2) as pool:
    locaux = pool.map(o3.histo_local, [ages[:moitie], ages[moitie:]])
total = locaux[0] + locaux[1]
t_local = time.perf_counter() - t0
print("locale   :", [int(v) for v in total], f"  {t_local:.2f} s")
print("mêmes histogrammes :", [int(v) for v in total] == list(hist))
Résultat →
locale   : [7170, 20090, 20790, 17350, 12590, 8450, 5920, 3280, 4360]   0.03 s
mêmes histogrammes : TrueLes deux versions donnent le même histogramme (dix fois \(717\), \(2\,009\), \(2\,079\), …), mais la version locale est bien plus rapide. La version partagée fait \(100\,000\) écritures protégées dans une petite zone que les deux cœurs se disputent ; la version locale ne partage rien pendant le calcul et ne fusionne qu’une fois, à la fin. C’est la règle de la Séance 2 : une donnée écrite souvent ne doit appartenir qu’à un seul cœur.
Calculer de la même façon, en version locale, l’histogramme de la fièvre par demi-degré : remplacer a // 10 par une fonction qui range fievre dans l’intervalle \([36{,}0 ; 41{,}5]\) par pas de \(0{,}5\). Combien de cases faut-il ?
Cellule 14 — à compléter
# cases = ((df['fievre'] - 36.0) / 0.5).astype(int) ...Partie 5 — Partager un grand tableau sans le copier
shared_memory.SharedMemory crée une zone de mémoire qui porte un nom. Le notebook y range un tableau NumPy ; chaque processus s’y attache par ce nom et lit sa part, sans rien copier. C’est l’idée du placement de la Séance 4 : chaque cœur travaille sur un bloc de données qui lui est attribué.
Cellule 15
taille = 10_000_000
shm = shared_memory.SharedMemory(create=True, size=taille * 8)    # 80 Mo partagés
partage = np.ndarray((taille,), dtype=np.float64, buffer=shm.buf)
partage[:] = 1.0                                                   # remplir le tableau

blocs = [(shm.name, taille, 0, taille // 2), (shm.name, taille, taille // 2, taille)]
with mp.Pool(2) as pool:
    print("somme :", sum(pool.starmap(o3.somme_partagee, blocs)))
    t_partage = chrono(lambda: pool.starmap(o3.somme_partagee, blocs), repetitions=2)
print(f"2 processus, mémoire partagée : {t_partage:.4f} s")
print(f"2 processus, avec copies       : {t_copie:.4f} s")
Résultat →
somme : 10000000.0
2 processus, mémoire partagée : 0.0087 s
2 processus, avec copies : 0.4691 sLa somme est juste (\(10\) millions) et le calcul ne transmet plus que des noms et des bornes : il est beaucoup plus rapide que la version avec copies de la Partie 2. Chaque processus lit uniquement son bloc, la moitié basse ou la moitié haute du tableau.
Découper le tableau en \(4\) blocs au lieu de \(2\) et vérifier que la somme est toujours \(10\,000\,000\).
Cellule 16 — à compléter
# blocs4 = [...]Cellule 17
del partage
shm.close()
shm.unlink()               # libérer la mémoire partagée, une seule fois, à la fin
print("mémoire partagée libérée")
Résultat →
mémoire partagée libéréeAttention. Une zone SharedMemory survit tant qu’on ne l’a pas libérée avec unlink(). Toujours terminer par la cellule précédente ; en cas d’erreur au milieu, redémarrer le noyau libère aussi la zone sous Windows.
Ce qu’il faut retenir
- Le processeur lit la mémoire par lignes de 64 octets : lire des données voisines est rapide, sauter d’un endroit à l’autre est lent, même avec le même nombre d’opérations.
- Chaque processus reçoit une copie de ce qu’on lui envoie ; copier de grosses données peut coûter plus que le calcul.
- Plusieurs processus qui écrivent la même donnée perdent des mises à jour (course critique) ; un verrou les répare, mais ralentit.
- La bonne forme : calcul local, fusion à la fin ; et pour de gros tableaux, une mémoire partagée où chacun lit sa part.
Lab suivant : synchroniser des fils — verrous, sémaphores, files d’attente et interblocage.
Pour cette séance
Le cours
Les slides
À lire en ligne
À télécharger
- Lab 3 — La mémoire : caches, copies et partage
Télécharger le notebook (.ipynb, 65 Ko) - Notebooks des labs de la séance 2 (ZIP, 36 Ko)
- Programmes C du faux partage, mesurés dans le cours (ZIP, 2 Ko)