Lab 1 — Penser parallèle : map, reduce et tâches indépendantes
Avant de lancer plusieurs cœurs, il faut savoir ce qui peut être découpé. Ce lab part de deux outils vus au Lab 0, map et reduce, et montre pourquoi ils sont la porte d’entrée du parallélisme : map applique une fonction à des données indépendantes, reduce combine des résultats partiels. On termine en confiant un vrai travail (compter les mots de huit textes) à plusieurs processus, et en mesurant l’accélération et l’efficacité de la Séance 1.
Prérequis : Lab 0. Durée estimée : 1 h 30.
Les blocs sans titre sont des commandes à taper dans le terminal (Anaconda Prompt) ; les blocs titrés « Cellule » sont le contenu des cellules du notebook, numérotées dans l’ordre ; les blocs titrés « Résultat » montrent le résultat obtenu (les durées et les numéros de processus changent d’une machine à l’autre). Pour copier un bloc : cliquer sur l’icône de copie, en haut à droite du bloc, puis le coller dans la cellule ; l’indentation est conservée. Le notebook complet est aussi à télécharger (panneau « Pour cette séance » de cette page).
Partie 0 — Mise en place
Cellule 1
import os, time, random
from functools import reduce
from collections import Counter
import multiprocessing as mp
import matplotlib.pyplot as plt

def chrono(f, *args, repetitions=3):
    """exécute f(*args) plusieurs fois et rend la durée la plus courte, en secondes"""
    meilleure = float("inf")
    for _ in range(repetitions):
        t0 = time.perf_counter()
        f(*args)
        meilleure = min(meilleure, time.perf_counter() - t0)
    return meilleure

print("coeurs de la machine :", os.cpu_count())
Résultat →
coeurs de la machine : 2Partie 1 — Une même fonction, beaucoup de données
La météo de Saint-Louis donne les températures de la semaine en degrés Celsius ; on veut les convertir en Fahrenheit, avec \(F = C\times9/5+32\). Chaque conversion ne dépend que de sa température : les sept calculs sont indépendants.
Cellule 2
def celsius_vers_fahrenheit(c):
    return c * 9 / 5 + 32

semaine = [24, 26, 27, 25, 29, 30, 28]
print(list(map(celsius_vers_fahrenheit, semaine)))
Résultat →
[75.2, 78.8, 80.6, 77.0, 84.2, 86.0, 82.4]map produit une valeur par jour, dans l’ordre. Sept cœurs pourraient faire chacun une conversion : le résultat serait le même, parce qu’aucune conversion n’a besoin d’une autre. C’est ce que l’on appelle des tâches indépendantes, la forme de travail la plus simple à paralléliser.
Avec map, convertir les mêmes températures en kelvins (\(K = C + 273{,}15\)).
Cellule 3 — à compléter
# kelvins = list(map(...))1.1 Fonction pure, fonction impure
Une fonction pure ne dépend que de ses arguments et ne modifie rien autour d’elle. La version impure ci-dessous ajoute chaque résultat à une liste globale.
Cellule 4
historique = []

def convertir_et_noter(c):                 # impure : modifie une variable globale
    f = c * 9 / 5 + 32
    historique.append(f)
    return f

list(map(convertir_et_noter, semaine))
list(map(convertir_et_noter, semaine))     # on recommence : l'historique grossit
print(len(historique), "valeurs dans l'historique")
Résultat →
14 valeurs dans l'historiqueExécuter deux fois le même calcul ne donne pas le même état : l’historique contient \(14\) valeurs. Si plusieurs cœurs exécutaient cette fonction en même temps, ils écriraient tous dans la même liste ; c’est le problème des courses critiques de la Séance 3. Règle : pour paralléliser sans précaution, la fonction appliquée doit être pure.
Partie 2 — Combiner des résultats partiels : reduce
Pour additionner une liste, on peut la couper en morceaux, faire la somme de chaque morceau (chaque cœur la sienne), puis additionner les sommes partielles. La cellule suivante fait exactement cela, sans parallélisme, pour vérifier que le résultat ne change pas.
Cellule 5
ventes = [120, 340, 95, 410, 230, 180, 75, 300]   # huit boutiques, milliers de F

total = reduce(lambda a, b: a + b, ventes)            # en une seule fois
morceaux = [ventes[0:4], ventes[4:8]]                 # deux morceaux, un par coeur
partiels = [reduce(lambda a, b: a + b, m) for m in morceaux]
total_decoupe = reduce(lambda a, b: a + b, partiels)

print("en une fois :", total)
print("sommes partielles :", partiels, " total :", total_decoupe)
Résultat →
en une fois : 1750
sommes partielles : [965, 785] total : 1750Les deux façons donnent \(1\,750\). Découper ne change rien, parce que l’addition est associative : \((a+b)+c = a+(b+c)\). Le découpage n’est donc correct que pour des opérations qui ont cette propriété.
Cellule 6
# La même chose avec la soustraction
d_une_fois = reduce(lambda a, b: a - b, ventes)
partiels = [reduce(lambda a, b: a - b, m) for m in morceaux]
d_decoupe = reduce(lambda a, b: a - b, partiels)
print("en une fois :", d_une_fois, "   découpé :", d_decoupe)
Résultat →
en une fois : -1510 découpé : -400Les deux résultats diffèrent : la soustraction n’est pas associative, \((a-b)-c\neq a-(b-c)\). Avant de découper un reduce entre plusieurs cœurs, il faut vérifier que l’opération est associative.
Refaire le découpage en deux morceaux avec max (lambda\ a,\ b:\ a\ if\ a\ >\ b\ else\ b). Le résultat change-t-il ? Le max est-il associatif ?
Cellule 7 — à compléter
# le maximum, en une fois puis découpé2.1 Et la moyenne ?
La moyenne de deux moyennes n’est pas la moyenne de l’ensemble si les morceaux n’ont pas la même taille. On combine donc des couples (somme, effectif), qui eux s’additionnent.
Cellule 8
morceaux = [ventes[0:3], ventes[3:8]]          # morceaux de tailles différentes
fausse = sum(sum(m) / len(m) for m in morceaux) / 2      # moyenne des moyennes
couples = [(sum(m), len(m)) for m in morceaux]  # (somme, effectif) par morceau
s, n = reduce(lambda a, b: (a[0] + b[0], a[1] + b[1]), couples)
print("moyenne des moyennes :", round(fausse, 2), "   vraie moyenne :", s / n)
Résultat →
moyenne des moyennes : 212.0 vraie moyenne : 218.75La moyenne des moyennes (\(212\)) se trompe ; en combinant les couples (somme, effectif), on retrouve la vraie moyenne \(218{,}75\). Choisir ce que chaque cœur renvoie, pour que la combinaison soit juste, est une étape de toute parallélisation.
Partie 3 — Map-reduce sur des textes
Un exemple de travail réel : compter les mots de plusieurs fichiers de texte. Map : compter les mots de chaque fichier, indépendamment. Reduce : additionner les comptes. C’est le principe de MapReduce, l’outil de Google pour traiter des milliers de fichiers sur des milliers de machines.
La cellule suivante fabrique huit fichiers de texte (graine fixe : tout le monde obtient les mêmes).
Cellule 9
mots_possibles = ("Dakar Thiès Kaolack Ziguinchor marché poisson riz mil arachide "
                  "pluie soleil école étudiant cours calcul coeur processeur "
                  "mémoire donnée réseau").split()

def fabriquer_fichiers(n_fichiers=8, n_mots=300_000, graine=221):
    rng = random.Random(graine)
    noms = []
    for k in range(n_fichiers):
        nom = f"texte_{k}.txt"
        with open(nom, "w", encoding="utf-8") as f:
            f.write(" ".join(rng.choice(mots_possibles) for _ in range(n_mots)))
        noms.append(nom)
    return noms

fichiers = fabriquer_fichiers()
print(fichiers)
Résultat →
['texte_0.txt', 'texte_1.txt', 'texte_2.txt', 'texte_3.txt', 'texte_4.txt', 'texte_5.txt', 'texte_6.txt', 'texte_7.txt']Le comptage des mots d’un fichier sera confié à des processus : il s’écrit donc dans un module (règle du Lab 0).
Cellule 10
from collections import Counter

def compter_mots(nom_fichier):
    """rend un Counter {mot: nombre d'apparitions} pour un fichier"""
    with open(nom_fichier, encoding="utf-8") as f:
        mots = f.read().lower().split()
    return Counter(mots)
Résultat →
Writing outils_lab1.pyCellule 11
from outils_lab1 import compter_mots

t0 = time.perf_counter()
comptes = list(map(compter_mots, fichiers))            # map : un Counter par fichier
total = reduce(lambda a, b: a + b, comptes)            # reduce : additionner
duree_seq = time.perf_counter() - t0

print("mots comptés :", sum(total.values()))
print("les 5 plus fréquents :", total.most_common(5))
print(f"durée en séquentiel : {duree_seq:.2f} s")
Résultat →
mots comptés : 2400000
les 5 plus fréquents : [('étudiant', 120497), ('thiès', 120483), ('cours', 120432), ('réseau', 120299), ('mil', 120237)]
durée en séquentiel : 0.55 s\(8\times300\,000=2\,400\,000\) mots. Deux Counter s’additionnent mot par mot, et cette addition est associative : on peut combiner les comptes dans n’importe quel ordre.
Partie 4 — De map à Pool.map
Pool.map a la même forme que map, mais répartit les fichiers entre plusieurs processus. Seule la ligne du map change.
Cellule 12
t0 = time.perf_counter()
with mp.Pool(2) as pool:
    comptes_p = pool.map(compter_mots, fichiers)        # map, réparti sur 2 processus
total_p = reduce(lambda a, b: a + b, comptes_p)         # reduce, dans le notebook
duree_2 = time.perf_counter() - t0

print("même résultat qu'en séquentiel :", total_p == total)
print(f"séquentiel : {duree_seq:.2f} s   2 processus : {duree_2:.2f} s")
Résultat →
même résultat qu'en séquentiel : True
séquentiel : 0.55 s 2 processus : 0.38 sLe résultat est identique, et la durée diminue : deux processus comptent deux fichiers à la fois. Elle ne diminue pas tout à fait de moitié, car démarrer les processus et leur envoyer les résultats prend du temps.
4.1 Accélération et efficacité
La Séance 1 définit, pour \(p\) processus :
- l’accélération \(S(p) = T(1)/T(p)\) : combien de fois plus vite qu’avec un seul ;
- l’efficacité \(E(p) = S(p)/p\) : la part du travail des \(p\) cœurs vraiment utile (\(1\) = parfait).
Cellule 13
def compter_avec(p):
    with mp.Pool(p) as pool:
        return reduce(lambda a, b: a + b, pool.map(compter_mots, fichiers))

P = [p for p in (1, 2, 4, 8) if p <= os.cpu_count()]
T = {p: chrono(compter_avec, p, repetitions=2) for p in P}
print(" p   durée (s)   S(p)   E(p)")
for p in P:
    S = T[1] / T[p]
    print(f"{p:2d}   {T[p]:8.2f}   {S:5.2f}   {S / p:5.2f}")
Résultat →
 p   durée (s)   S(p)   E(p)
 1       0.57    1.00    1.00
 2       0.32    1.77    0.88
Cellule 14
plt.figure(figsize=(5.5, 3.5))
plt.plot(P, P, "--", color="gray", label="idéal : S = p")
plt.plot(P, [T[1] / T[p] for p in P], "o-", label="mesuré")
plt.xlabel("nombre de processus p"); plt.ylabel("accélération S(p)")
plt.title("Compter les mots de 8 fichiers"); plt.legend(); plt.show()
Résultat →
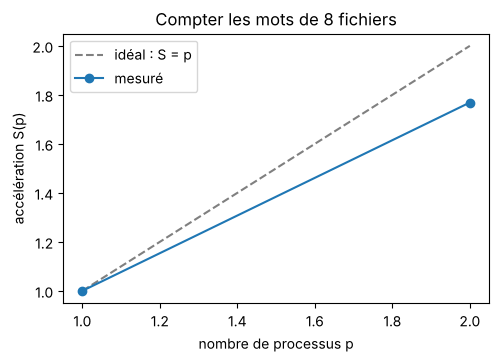
La courbe mesurée reste sous la droite idéale, et s’en écarte quand \(p\) augmente : une partie du travail ne se partage pas (lire la liste des fichiers, additionner les comptes, lancer les processus). Sur une machine à deux cœurs, la courbe s’arrête à \(p=2\) ; sur une machine à huit cœurs, elle va plus loin.
Refaire la mesure avec \(16\) fichiers au lieu de \(8\) (fichiers = fabriquer_fichiers(16)). L’efficacité change-t-elle ?
Cellule 15 — à compléter
# fichiers = fabriquer_fichiers(16) ; ...Partie 5 — Lire des mesures : la part séquentielle
Un programme a été mesuré sur 1, 2, 4 et 8 cœurs : \(10\) s, \(5{,}5\) s, \(3{,}2\) s et \(2{,}1\) s. La loi d’Amdahl (Séance 1) dit qu’avec une part séquentielle \(f\), \(S(p) = 1/(f + (1-f)/p)\). En retournant la formule, chaque mesure donne une estimation de \(f\) : \(f = (p/S - 1)/(p - 1)\).
Cellule 16
mesures = {1: 10.0, 2: 5.5, 4: 3.2, 8: 2.1}           # durées en secondes

print(" p   S(p)   E(p)   f estimée")
for p, t in mesures.items():
    S = mesures[1] / t
    f = f"{(p / S - 1) / (p - 1):6.3f}" if p > 1 else "     -"
    print(f"{p:2d}   {S:4.2f}   {S / p:4.2f}   {f}")
Résultat →
 p   S(p)   E(p)   f estimée
 1   1.00   1.00        -
 2   1.82   0.91    0.100
 4   3.12   0.78    0.093
8 4.76 0.60 0.097Les trois estimations sont voisines de \(0{,}1\) : environ \(10\) % du programme est séquentiel. La loi d’Amdahl prévoit alors une accélération qui ne dépassera jamais \(1/f = 10\), quel que soit le nombre de cœurs.
Avec \(f = 0{,}1\), calculer l’accélération prévue par Amdahl pour \(p = 16, 64, 1024\).
Cellule 17 — à compléter
# amdahl = lambda f, p: ...Pour finir
Cellule 18
for f in fichiers + [f"texte_{k}.txt" for k in range(16)]:
    if os.path.exists(f): os.remove(f)                  # nettoyer les fichiers de texte
print("fichiers de texte supprimés")
Résultat →
fichiers de texte supprimésCe qu’il faut retenir. Des tâches indépendantes et une fonction pure se répartissent entre cœurs sans rien changer au résultat (map → Pool.map). Des résultats partiels se combinent par reduce si l’opération est associative ; sinon, on combine autre chose (des couples somme et effectif). L’accélération mesurée reste sous l’idéal, et sa forme permet d’estimer la part séquentielle du programme.
Lab suivant : plusieurs cœurs pour du calcul, la granularité des tâches et la loi d’Amdahl mesurée.
Pour cette séance
Le cours
Les slides
À lire en ligne
- TD — Séance 1 — Fondements de l’architecture parallèle
- Lab 0 — Prise en main : Anaconda, Jupyter et les outils Python des labs (énoncé)
- Lab 0 — Prise en main : Anaconda, Jupyter et les outils Python des labs
- Lab 1 — Penser parallèle : map, reduce et tâches indépendantes
- Lab 2 — Plusieurs cœurs : multiprocessing, granularité et loi d’Amdahl (énoncé)
- Lab 2 — Plusieurs cœurs : multiprocessing, granularité et loi d’Amdahl
À télécharger
- Lab 0 — Prise en main : Anaconda, Jupyter et les outils Python des labs
Télécharger le notebook (.ipynb, 80 Ko) - Lab 1 — Penser parallèle : map, reduce et tâches indépendantes
Télécharger le notebook (.ipynb, 68 Ko) - Lab 2 — Plusieurs cœurs : multiprocessing, granularité et loi d’Amdahl
Télécharger le notebook (.ipynb, 110 Ko) - Notebooks des labs de la séance 1 (ZIP, 147 Ko)