Chaque notion suit le même chemin : une explication courte, un exemple à exécuter, une Lecture qui dit quoi regarder, puis parfois un petit À faire qui refait la même chose en changeant un détail.
Télécharger le notebookLes sorties sont celles enregistrées dans le notebook : rien n'est réexécuté.
Prise en main : Anaconda, Jupyter et les outils Python des labs
Dr. El Hadji Bassirou TOURÉ · DMI · FST · UCAD
Ce lab prépare les quatre suivants. Il installe l’environnement de travail, puis passe en revue, une par une, les notions Python dont les labs auront besoin : fonctions, lambda et map, mesure du temps, NumPy et matplotlib, modules, et les deux façons de faire travailler plusieurs choses en même temps, les fils (threads) et les processus.
Chaque notion suit le même chemin : une explication courte, un exemple à exécuter, une Lecture qui dit quoi regarder, puis parfois un petit À faire qui refait la même chose en changeant un détail.
Durée estimée : 1 h 30.
Partie 1 — Installer et lancer l’environnement
1.1 Installer Anaconda
Anaconda regroupe Python, Jupyter et les bibliothèques scientifiques (NumPy, pandas, matplotlib, scikit-learn). Le télécharger sur anaconda.com/download (version pour Windows, macOS ou Linux), puis l’installer avec les options proposées par défaut.
1.2 Créer l’environnement du cours
Un environnement est une installation de Python séparée, avec ses propres bibliothèques : ce que l’on y installe ne dérange pas le reste de la machine. Ouvrir Anaconda Prompt (Windows) ou un Terminal (macOS, Linux), puis taper :
conda create -n para python=3.12 jupyterlab numpy pandas matplotlib scikit-learn
conda activate para
jupyter lab
La première ligne crée l’environnement para (une seule fois). La deuxième l’active (à chaque nouvelle session). La troisième ouvre JupyterLab dans le navigateur.
1.3 Ouvrir ce notebook
Dans JupyterLab, à gauche, naviguer jusqu’au dossier qui contient ce fichier, puis double-cliquer sur LAB0_Prise_en_main.ipynb. Tous les labs du cours se rangent dans ce même dossier : ils y écrivent de petits fichiers Python (Partie 7).
1.4 Exécuter une cellule
Un notebook est une suite de cellules. Une cellule de code s’exécute avec Maj + Entrée ; son résultat s’affiche juste en dessous. Une cellule de texte (Markdown, comme celle-ci) s’affiche mise en forme.
Exécuter la cellule suivante : elle vérifie que tout est installé.
Lecture. Si la cellule affiche les versions sans erreur, l’environnement est prêt. Noter le nombre de cœurs de la machine : c’est le nombre de calculs que le processeur peut mener réellement en même temps, et il reviendra dans tous les labs. Une erreur ModuleNotFoundError signifie que l’environnement para n’est pas activé, ou qu’une bibliothèque manque : refaire la section 1.2.
Partie 2 — Le notebook garde une mémoire
Le noyau (kernel) est le programme Python qui exécute les cellules. Il garde en mémoire toutes les variables créées, dans l’ordre où les cellules ont été exécutées, qui n’est pas forcément l’ordre où elles sont écrites.
ville ="Thiès"print("ville vaut :", ville)
ville vaut : Thiès
ville ="Saint-Louis"print("ville vaut :", ville)
ville vaut : Saint-Louis
print("Bienvenue à", ville)
Bienvenue à Saint-Louis
Lecture. La dernière cellule affiche Saint-Louis : c’est la dernière valeur donnée à ville. Réexécuter la première cellule, puis la dernière : elle affiche maintenant Thiès. Le résultat dépend de l’ordre d’exécution.
En cas de doute, le menu Kernel → Restart Kernel and Run All Cells efface la mémoire et exécute tout dans l’ordre du notebook. C’est aussi le remède quand une cellule reste bloquée : l’astérisque [*] à gauche d’une cellule signale qu’elle est encore en cours d’exécution.
Partie 3 — Rappels de Python
3.1 Les fonctions
Une fonction reçoit des arguments et rend une valeur avec return. Un argument peut avoir une valeur par défaut.
def prix_ttc(prix_ht, taux=0.18): # TVA de 18 % par défautreturn prix_ht * (1+ taux)print(prix_ttc(10_000)) # taux par défautprint(prix_ttc(10_000, taux=0.10)) # taux donné
11800.0
11000.0
Lecture.10_000 s’écrit avec un tiret bas pour être lisible ; Python l’ignore. Sans taux, la fonction prend \(0{,}18\) : \(10\,000\times1{,}18=11\,800\).
À faire. Écrire une fonction prix_promo(prix, remise=0.2) qui rend le prix après remise, et l’essayer sur \(5\,000\) F avec la remise par défaut, puis avec une remise de \(0{,}5\).
# À compléter
3.2 Listes, boucles et compréhensions
Une liste range des valeurs dans l’ordre. Une boucle for les parcourt ; une compréhension construit une nouvelle liste en une ligne.
temperatures = [27, 31, 29, 35, 33] # températures de la semaine à Kaolackcarres = []for t in temperatures: # avec une boucle carres.append(t * t)print(carres)print([t * t for t in temperatures]) # la même chose, avec une compréhensionprint([t for t in temperatures if t >30]) # en ne gardant que les jours chauds
Lecture. La boucle et la compréhension donnent la même liste. La compréhension se lit : « \(t\times t\) pour chaque \(t\) de la liste », éventuellement « si \(t>30\) ».
À faire. Construire par compréhension la liste des températures en degrés Fahrenheit (\(F = C\times9/5+32\)), puis celle des jours à moins de \(30\) °C.
# À compléter
3.3 Dictionnaires et chaînes formatées
Un dictionnaire associe une clé à une valeur. Une chaîne précédée de f insère des valeurs entre accolades.
# ventes de la semaine, en F CFAventes = {"Sandaga": 1_250_000, "Colobane": 990_000, "HLM": 830_000}for marche, montant in ventes.items():print(f"{marche:8s} : {montant:>10,} F")print("Total :", sum(ventes.values()), "F")
Sandaga  :  1,250,000 F
Colobane :    990,000 F
HLM      :    830,000 F
Total : 3070000 F
Lecture.{marche:8s} réserve \(8\) caractères au nom ; {montant:>10,} aligne le nombre à droite sur \(10\) caractères avec un séparateur de milliers. Ces formats serviront à aligner les tableaux de mesures des labs.
Partie 4 — Les fonctions comme valeurs : lambda, map, reduce
En Python, une fonction est une valeur comme une autre : on peut la ranger dans une variable ou la passer à une autre fonction. C’est la porte d’entrée du parallélisme : appliquer la même fonction à beaucoup de données est exactement ce que plusieurs cœurs savent partager (Lab 1).
def double(x):return2* xtriple =lambda x: 3* x # une fonction anonyme, en une lignenombres = [1, 2, 3, 4, 5]print(list(map(double, nombres))) # map applique la fonction à chaque élémentprint(list(map(triple, nombres)))print(list(filter(lambda x: x %2==0, nombres))) # garde les éléments pairs
[2, 4, 6, 8, 10]
[3, 6, 9, 12, 15]
[2, 4]
Lecture.map(f, liste) calcule \(f\) de chaque élément ; les calculs sont indépendants les uns des autres : on pourrait les confier à cinq cœurs différents sans rien changer au résultat.
from functools importreducedef addition_bavarde(a, b):print(f" {a} + {b} = {a + b}")return a + bprint("reduce enchaîne les additions :")total =reduce(addition_bavarde, [1, 2, 3, 4, 5])print("total :", total)
Lecture.reduce combine les éléments deux à deux, de gauche à droite, jusqu’à une seule valeur. map puis reduce est le schéma de nombreux calculs parallèles : chaque cœur calcule sa part (map), puis on combine les parts (reduce).
À faire. Avec map et reduce, calculer la somme des carrés de \(1\) à \(10\) (résultat attendu : \(385\)).
# À compléter
4.1 Fonction pure, fonction impure
Une fonction pure rend toujours le même résultat pour les mêmes arguments et ne modifie rien en dehors d’elle. Une fonction impure lit ou modifie une variable extérieure.
compteur =0def carre_pur(x):return x * x # ne dépend que de xdef carre_impur(x):global compteur compteur +=1# modifie une variable extérieurereturn x * xprint(list(map(carre_pur, [1, 2, 3])), " compteur =", compteur)print(list(map(carre_impur, [1, 2, 3])), " compteur =", compteur)
[1, 4, 9]   compteur = 0
[1, 4, 9]   compteur = 3
Lecture. Les deux fonctions donnent les mêmes carrés, mais la seconde touche à compteur. Exécutée par plusieurs fils en même temps, elle poserait le problème central du Lab 4 : deux fils qui modifient la même variable. Une fonction pure se parallélise sans précaution.
Partie 5 — Mesurer le temps
Tous les labs comparent des durées. time.perf_counter() donne l’heure d’une horloge précise ; la différence entre deux lectures est une durée en secondes.
import timedef somme_boucle(n): total =0for i inrange(n): total += ireturn totalt0 = time.perf_counter()somme_boucle(5_000_000)print(f"durée : {time.perf_counter() - t0:.3f} s")
durée : 0.166 s
# Une même mesure, cinq foisfor essai inrange(5): t0 = time.perf_counter() somme_boucle(5_000_000)print(f"essai {essai} : {time.perf_counter() - t0:.3f} s")
essai 0 : 0.167 s
essai 1 : 0.163 s
essai 2 : 0.164 s
essai 3 : 0.170 s
essai 4 : 0.180 s
Lecture. Les cinq durées ne sont pas identiques : d’autres programmes de la machine prennent un peu de temps au processeur. Une mesure se lit donc à l’ordre de grandeur, et l’on garde de préférence la plus petite de plusieurs mesures. La fonction suivante, réutilisée dans tous les labs, fait exactement cela.
def chrono(f, *args, repetitions=3):"""exécute f(*args) plusieurs fois et rend la durée la plus courte, en secondes""" meilleure =float("inf")for _ inrange(repetitions): t0 = time.perf_counter() f(*args) meilleure =min(meilleure, time.perf_counter() - t0)return meilleureprint(f"somme_boucle(5 000 000) : {chrono(somme_boucle, 5_000_000):.3f} s")
somme_boucle(5 000 000) : 0.162 s
Lecture.*args transmet à f tous les arguments reçus, quel que soit leur nombre. Jupyter offre aussi la commande %timeit, qui répète la mesure automatiquement.
%timeit somme_boucle(1_000_000)
34.5 ms ± 2.23 ms per loop (mean ± std. dev. of 7 runs, 10 loops each)
À faire. Mesurer avec chrono la durée de somme_boucle pour \(n = 1, 2, 4, 8\) millions. La durée est-elle proportionnelle à \(n\) ?
# for n in [1_000_000, 2_000_000, 4_000_000, 8_000_000]: ...
Partie 6 — NumPy et matplotlib, le minimum
NumPy calcule sur des tableaux entiers d’un coup, en code compilé ; matplotlib trace des courbes. Les labs s’en servent pour calculer vite et pour dessiner les accélérations.
import numpy as npa = np.arange(5_000_000) # les entiers de 0 à 4 999 999print("somme NumPy :", a.sum())print("somme boucle :", somme_boucle(5_000_000))print(f"durée NumPy : {chrono(a.sum):.4f} s")print(f"durée boucle : {chrono(somme_boucle, 5_000_000):.4f} s")
somme NumPy  : 12499997500000
somme boucle : 12499997500000
durée NumPy  : 0.0021 s
durée boucle : 0.1631 s
Lecture. Même résultat, mais NumPy est beaucoup plus rapide : la boucle Python interprète chaque addition une à une, NumPy les enchaîne en code machine. Avant de paralléliser un calcul Python, il faut se demander s’il ne s’écrit pas d’abord avec NumPy.
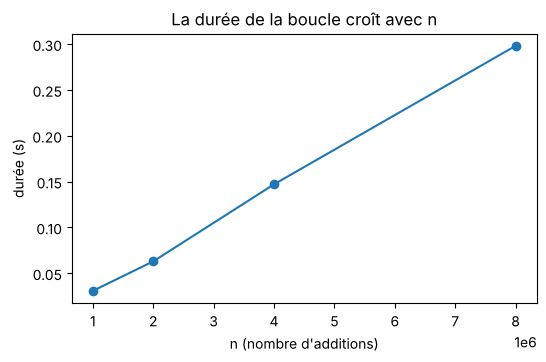
import matplotlib.pyplot as plttailles = [1_000_000, 2_000_000, 4_000_000, 8_000_000]durees = [chrono(somme_boucle, n) for n in tailles]plt.figure(figsize=(6, 3.5))plt.plot(tailles, durees, "o-")plt.xlabel("n (nombre d'additions)")plt.ylabel("durée (s)")plt.title("La durée de la boucle croît avec n")plt.show()
Lecture. Les points sont presque alignés : doubler \(n\) double la durée. Les labs traceront de la même façon la durée et l’accélération en fonction du nombre de cœurs.
6.1 Les données du cours : DataSANTÉ-221
Les labs utilisent parfois le jeu de données des cours de ML : \(10\,000\) patients fictifs (âge, glycémie, fièvre, paludisme…). La cellule suivante le fabrique ; ne pas la modifier.
Lecture.\(10\,000\) lignes, \(7\) colonnes. Le générateur utilise une graine (seed=221) : tout le monde obtient exactement les mêmes patients, et donc les mêmes résultats.
À faire. Calculer l’âge moyen des patients (df["age"].mean()) et la proportion de paludisme (df["paludisme"].mean()).
# À compléter
Partie 7 — Écrire un module
Un module est un fichier .py dont on importe les fonctions. Dans un notebook, la commande %%writefile placée en tête d’une cellule écrit le contenu de la cellule dans un fichier, au lieu de l’exécuter.
Pourquoi c’est indispensable pour les labs. Un processus lancé par multiprocessing est un nouveau programme Python. Sous Windows et macOS, il démarre vide et ne voit pas les cellules du notebook : il ne retrouve une fonction que si elle est dans un fichier qu’il peut importer. Règle des labs : toute fonction exécutée par des processus est écrite dans un module. Une fonction définie dans une cellule, confiée à des processus, laisse la cellule bloquée sur [*] : il faut alors redémarrer le noyau.
%%writefile outils_lab0.pyimport os, timedef carre(x):return x * xdef qui_suis_je(x):"""rend le numéro du processus (PID) qui a traité x""" time.sleep(0.5) # une tâche qui prend un peu de tempsreturn x, os.getpid()
Writing outils_lab0.py
from outils_lab0 import carre, qui_suis_jeprint(carre(7))
49
Lecture. La cellule %%writefile a créé le fichier outils_lab0.py dans le dossier du notebook (il apparaît dans le panneau de gauche). On l’importe ensuite comme n’importe quel module.
Attention. Si l’on modifie le module, Python garde l’ancienne version déjà importée. Pour charger la nouvelle : import importlib, outils_lab0; importlib.reload(outils_lab0), ou redémarrer le noyau.
Partie 8 — Premiers fils, premiers processus
Deux façons de faire plusieurs choses à la fois :
fil (threading)
processus (multiprocessing)
mémoire
partagée avec le notebook
une mémoire à lui
démarrage
rapide
plus lent (un nouveau Python)
calcul en Python pur
un seul fil calcule à la fois
plusieurs cœurs calculent vraiment
bon pour
attendre (fichiers, réseau)
calculer
8.1 Des fils
import threadingdef saluer(nom, attente): time.sleep(attente) # le fil attend, puis parleprint(f"Bonjour de {nom} (après {attente} s)")fils = [threading.Thread(target=saluer, args=(nom, att))for nom, att in [("Fatou", 0.3), ("Amadou", 0.1), ("Awa", 0.2)]]t0 = time.perf_counter()for f in fils: f.start() # start : le fil démarrefor f in fils: f.join() # join : attendre qu'il ait finiprint(f"durée totale : {time.perf_counter() - t0:.2f} s")
Bonjour de Amadou (après 0.1 s)
Bonjour de Awa (après 0.2 s)
Bonjour de Fatou (après 0.3 s)
durée totale : 0.30 s
Lecture. Les messages arrivent dans l’ordre des attentes (Amadou, Awa, Fatou), pas dans l’ordre de création : les trois fils s’exécutent en même temps. La durée totale est celle du plus long (\(0{,}3\) s), et non la somme (\(0{,}6\) s). start lance un fil ; join attend sa fin : sans join, la cellule pourrait continuer avant que les fils aient fini.
À faire. Ajouter Cheikh avec une attente de \(0{,}5\) s. Prédire la durée totale avant d’exécuter.
# À compléter
8.2 Des processus
multiprocessing.Pool(k) crée \(k\) processus ouvriers ; pool.map(f, liste) répartit les éléments de la liste entre eux, comme map, mais en parallèle. La fonction vient du module de la Partie 7.
import multiprocessing as mpt0 = time.perf_counter()with mp.Pool(2) as pool: # deux processus ouvriers resultats = pool.map(qui_suis_je, [1, 2, 3, 4])print(f"durée : {time.perf_counter() - t0:.2f} s")print("PID du notebook :", os.getpid())for x, pid in resultats:print(f" {x} traité par le processus {pid}")
durée : 1.02 s
PID du notebook : 2081
  1 traité par le processus 2105
  2 traité par le processus 2106
  3 traité par le processus 2105
  4 traité par le processus 2106
Lecture. Les quatre tâches ont été traitées par deux processus différents (deux PID), tous deux différents du notebook. Chaque tâche dure \(0{,}5\) s ; deux ouvriers en font deux à la fois : environ \(1\) s au lieu de \(2\), plus le temps de démarrage des processus. Le with ferme proprement les processus à la fin du bloc.
À faire. Refaire la mesure avec mp.Pool(4), puis mp.Pool(1). Comment la durée évolue-t-elle ?
# À compléter
8.3 Un processus ne partage pas la mémoire du notebook
%%writefile outils_lab0_compteur.pyimport os, timecompteur =0def incrementer(x):"""ajoute 1 au compteur du module et rend (PID, valeur du compteur)"""global compteur compteur +=1 time.sleep(0.1)return os.getpid(), compteur
Writing outils_lab0_compteur.py
import outils_lab0_compteur as ocwith mp.Pool(2) as pool: resultats = pool.map(oc.incrementer, range(6), chunksize=1)for pid insorted(set(p for p, _ in resultats)): valeurs = [v for p, v in resultats if p == pid]print(f"processus {pid} : son compteur est passé par {valeurs}")print("compteur dans le notebook :", oc.compteur)
processus 2110 : son compteur est passé par [1, 2, 3]
processus 2112 : son compteur est passé par [1, 2, 3]
compteur dans le notebook : 0
Lecture. Six incréments en tout, mais chaque processus a compté de son côté à partir de \(0\) : chacun a sa propre copie de compteur, et celui du notebook vaut toujours \(0\). Des processus ne partagent rien sans le demander : c’est pourquoi ils ne se gênent pas (Lab 2), et pourquoi il faudra des outils spéciaux pour qu’ils mettent des résultats en commun (Labs 3 et 4). Des fils, au contraire, partagent toutes les variables du notebook.
Bilan — Ce qui servira dans les labs suivants
notion du Lab 0
utilisée dans
fonctions, compréhensions, f-strings
tous les labs
map, reduce, fonctions pures
Lab 1 (penser parallèle)
chrono, %timeit, lecture des mesures
Labs 1 à 4
NumPy, matplotlib
Lab 2 (courbes d’accélération), Lab 3 (mémoire et caches)
module écrit par %%writefile
dès qu’il y a des processus
threading.Thread, start, join
Lab 4 (synchroniser)
multiprocessing.Pool, mémoire séparée
Labs 2 et 3
Avant le Lab 1, vérifier :
La cellule de la section 1.4 affiche toutes les versions.
Kernel → Restart Kernel and Run All Cells exécute ce notebook sans erreur.
Le fichier outils_lab0.py apparaît dans le dossier.