Lab 2 — Plusieurs cœurs : multiprocessing, granularité et loi d’Amdahl
Le Lab 1 a montré qu’un travail découpé en tâches indépendantes se confie à plusieurs processus. Ce lab mesure ce que l’on y gagne vraiment : l’accélération sur un calcul de nombres premiers, le prix des tâches trop petites, les tâches de durées inégales, la loi d’Amdahl confrontée à une mesure, et pour finir le calcul de \(\pi\) par la méthode de Monte-Carlo.
Prérequis : Labs 0 et 1. Durée estimée : 1 h 30.
Les blocs sans titre sont des commandes à taper dans le terminal (Anaconda Prompt) ; les blocs titrés « Cellule » sont le contenu des cellules du notebook, numérotées dans l’ordre ; les blocs titrés « Résultat » montrent le résultat obtenu (les durées et les numéros de processus changent d’une machine à l’autre). Pour copier un bloc : cliquer sur l’icône de copie, en haut à droite du bloc, puis le coller dans la cellule ; l’indentation est conservée. Le notebook complet est aussi à télécharger (panneau « Pour cette séance » de cette page).
Partie 0 — Mise en place
Toutes les fonctions confiées aux processus sont dans le module outils_lab2.py, écrit par la cellule suivante.
Cellule 1
import math, random, time

def est_premier(n):
    if n < 2:
        return False
    if n % 2 == 0:
        return n == 2
    for d in range(3, math.isqrt(n) + 1, 2):    # diviseurs impairs <= racine de n
        if n % d == 0:
            return False
    return True

def compter_premiers(intervalle):
    debut, fin = intervalle
    return sum(1 for n in range(debut, fin) if est_premier(n))

def carre(x):
    return x * x

def distance(x1, y1, x2, y2):
    return math.hypot(x2 - x1, y2 - y1)

def tache_longue(numero, duree):
    time.sleep(duree)                                # une tâche qui attend
    return numero * numero

def calcul(n):
    """un calcul de durée proportionnelle à n"""
    s = 0
    for i in range(n):
        s += i % 7
    return s

def monte_carlo(n, graine):
    """tire n points dans le carré [0, 1] x [0, 1] ;
    rend le nombre de points tombés dans le quart de disque de rayon 1"""
    rng = random.Random(graine)
    dedans = 0
    for _ in range(n):
        x, y = rng.random(), rng.random()
        if x * x + y * y <= 1:
            dedans += 1
    return dedans
Résultat →
Writing outils_lab2.pyCellule 2
import os, time, math
import multiprocessing as mp
import matplotlib.pyplot as plt
from outils_lab2 import (est_premier, compter_premiers, carre, distance,
                         tache_longue, calcul, monte_carlo)

def chrono(f, *args, repetitions=3):
    """exécute f(*args) plusieurs fois et rend la durée la plus courte, en secondes"""
    meilleure = float("inf")
    for _ in range(repetitions):
        t0 = time.perf_counter()
        f(*args)
        meilleure = min(meilleure, time.perf_counter() - t0)
    return meilleure

P = [p for p in (1, 2, 4, 8) if p <= os.cpu_count()]   # nombres de processus à essayer
print("coeurs :", os.cpu_count(), "  essais avec p =", P)
Résultat →
coeurs : 2 essais avec p = [1, 2]Partie 1 — Compter les nombres premiers sur plusieurs cœurs
Combien y a-t-il de nombres premiers inférieurs à \(300\,000\) ? Chaque nombre se teste indépendamment des autres. On découpe l’intervalle \([0, 300\,000[\) en \(8\) morceaux égaux, un morceau étant une tâche.
Cellule 3
N = 300_000
morceaux = [(k * N // 8, (k + 1) * N // 8) for k in range(8)]
print(morceaux)

t0 = time.perf_counter()
total = compter_premiers((0, N))
print(f"séquentiel : {total} nombres premiers en {time.perf_counter() - t0:.2f} s")
Résultat →
[(0, 37500), (37500, 75000), (75000, 112500), (112500, 150000), (150000, 187500), (187500, 225000), (225000, 262500), (262500, 300000)]
séquentiel : 25997 nombres premiers en 0.28 s
Cellule 4
def premiers_avec(p):
    with mp.Pool(p) as pool:
        return sum(pool.map(compter_premiers, morceaux))

print("même résultat :", premiers_avec(2) == total)
T = {p: chrono(premiers_avec, p, repetitions=2) for p in P}
print(" p   durée (s)   S(p)   E(p)")
for p in P:
    print(f"{p:2d}   {T[p]:8.2f}   {T[1] / T[p]:5.2f}   {T[1] / T[p] / p:5.2f}")
Résultat →
même résultat : True
 p   durée (s)   S(p)   E(p)
 1       0.32    1.00    1.00
 2       0.17    1.91    0.96
Cellule 5
plt.figure(figsize=(5.5, 3.5))
plt.plot(P, P, "--", color="gray", label="idéal : S = p")
plt.plot(P, [T[1] / T[p] for p in P], "o-", label="mesuré")
plt.xlabel("nombre de processus p"); plt.ylabel("accélération S(p)")
plt.title("Nombres premiers inférieurs à 300 000"); plt.legend(); plt.show()
Résultat →
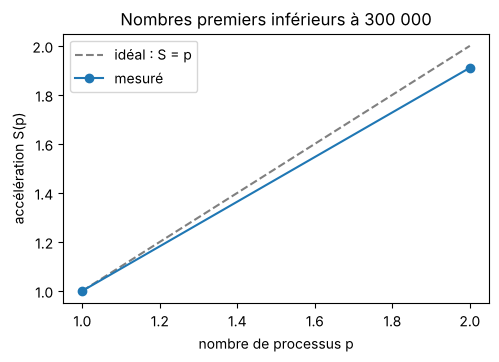
Les processus trouvent les mêmes \(25\,997\) nombres premiers, plus vite. L’accélération reste sous la droite idéale : chaque processus doit démarrer, recevoir sa tâche et renvoyer son résultat, et ce surcoût ne se partage pas. L’efficacité \(E(p)\) dit quelle part du temps des \(p\) cœurs a servi au calcul.
1.1 Des tâches de durées inégales
Tester un grand nombre coûte plus cher que tester un petit (il y a plus de diviseurs à essayer). Les \(8\) morceaux ont la même largeur, mais pas la même durée.
Cellule 6
for m in morceaux:
    print(f"{str(m):18s} {chrono(compter_premiers, m, repetitions=1):.3f} s")
Résultat →
(0, 37500)         0.016 s
(37500, 75000)     0.024 s
(75000, 112500)    0.029 s
(112500, 150000)   0.032 s
(150000, 187500)   0.036 s
(187500, 225000)   0.038 s
(225000, 262500)   0.040 s
(262500, 300000) 0.047 sLe dernier morceau dure nettement plus que le premier. Avec deux processus et deux gros morceaux (la moitié basse et la moitié haute), le processus de la moitié haute finit en dernier pendant que l’autre attend : c’est le déséquilibre de charge. Avec beaucoup de petits morceaux, chaque processus prend le suivant dès qu’il est libre, et les durées s’équilibrent.
Avec mp.Pool(2), mesurer le temps total pour \(2\) morceaux, puis pour \(16\), puis pour \(64\) morceaux de même largeur. Lequel est le plus rapide ? Pourquoi \(64\) morceaux ne font-ils pas forcément mieux que \(16\) ?
Cellule 7 — à compléter
# for k in (2, 16, 64): ...Partie 2 — La granularité : des tâches trop petites
Chaque tâche envoyée à un processus coûte un aller-retour : préparer les données, les transmettre, récupérer le résultat. Si la tâche elle-même est minuscule, ce coût domine (Séance 1, granularité).
Cellule 8
nombres = list(range(200_000))

t_seq = chrono(lambda: list(map(carre, nombres)))
with mp.Pool(2) as pool:
    t_par = chrono(lambda: pool.map(carre, nombres))
    petits = nombres[:20_000]
    t_fin = chrono(lambda: pool.map(carre, petits, chunksize=1), repetitions=1)

print(f"séquentiel, 200 000 carrés         : {t_seq:.3f} s")
print(f"2 processus, 200 000 carrés         : {t_par:.3f} s")
print(f"2 processus, 20 000 carrés un par un : {t_fin:.3f} s")
Résultat →
séquentiel, 200 000 carrés         : 0.011 s
2 processus, 200 000 carrés         : 0.035 s
2 processus, 20 000 carrés un par un : 0.575 sCalculer un carré prend quelques dizaines de nanosecondes ; l’envoyer à un autre processus prend bien plus. Le parallélisme est donc plus lent que le séquentiel. Et en envoyant les nombres un par un (chunksize=1), dix fois moins de carrés prennent encore plus de temps. chunksize regroupe les éléments en paquets : moins d’allers- retours, mais des paquets plus gros à équilibrer.
Mesurer pool.map(carre, nombres, chunksize=c) pour \(c = 10, 100, 1\,000, 10\,000\). À partir de quelle taille de paquet la durée cesse-t-elle de diminuer ?
Cellule 9 — à compléter
# for c in (10, 100, 1000, 10000): ...Partie 3 — Plusieurs arguments (starmap) et tâches asynchrones (apply_async)
pool.map(f, liste) passe un argument à f. Pour une fonction à plusieurs arguments, pool.starmap(f, liste) prend une liste de tuples et « déballe » chaque tuple.
Cellule 10
# distances (en km, sur une carte simplifiée) entre des paires de villes
paires = [(0, 0, 70, 10),       # Dakar -> Thiès
          (0, 0, 190, 60),      # Dakar -> Kaolack
          (70, 10, 250, 230)]   # Thiès -> Saint-Louis
with mp.Pool(2) as pool:
    d = pool.starmap(distance, paires)
print([round(x, 1) for x in d])
Résultat →
[70.7, 199.2, 284.3]starmap appelle distance(0, 0, 70, 10), puis distance(0, 0, 190, 60), etc. ; les résultats reviennent dans l’ordre des paires.
apply_async lance une tâche et rend aussitôt la main, avec un objet qui donnera le résultat plus tard. On peut lancer plusieurs tâches, faire autre chose, puis récupérer les résultats.
Cellule 11
with mp.Pool(2) as pool:
    t0 = time.perf_counter()
    taches = [pool.apply_async(tache_longue, (k, d))
              for k, d in [(1, 0.6), (2, 0.3), (3, 0.5), (4, 0.2)]]
    print(f"4 tâches lancées en {time.perf_counter() - t0:.3f} s : sans attendre")
    time.sleep(0.35)
    print("terminées après 0,35 s :", [t.ready() for t in taches])
    resultats = [t.get() for t in taches]               # get attend le résultat
    print("résultats :", resultats, f" durée totale : {time.perf_counter() - t0:.2f} s")
Résultat →
4 tâches lancées en 0.000 s : sans attendre
terminées après 0,35 s : [False, True, False, False]
résultats : [1, 4, 9, 16] durée totale : 0.80 sLes quatre lancements sont instantanés. Après \(0{,}35\) s, seule la tâche de \(0{,}3\) s est finie (True) : deux processus travaillent à la fois. get() attend chaque résultat ; la durée totale est d’environ \(0{,}8\) s, au lieu de \(1{,}6\) s en séquentiel.
Refaire la même chose avec mp.Pool(4). Que deviennent les ready() après \(0{,}35\) s et la durée totale ?
Cellule 12 — à compléter
# with mp.Pool(4) as pool: ...Partie 4 — La loi d’Amdahl, mesurée
Un programme a une partie séquentielle (faite par le notebook seul, comme lire des données) et une partie parallélisable (8 calculs confiés aux processus). La loi d’Amdahl prévoit, avec \(f\) la part séquentielle du temps à un seul cœur : \[S(p) = \frac{1}{f + (1 - f)/p}.\]
Cellule 13
def programme(p):
    calcul(10_000_000)                                  # partie séquentielle
    with mp.Pool(p) as pool:
        pool.map(calcul, [5_000_000] * 8)              # partie parallélisable

amdahl = lambda f, p: 1 / (f + (1 - f) / p)
t_s = chrono(calcul, 10_000_000)              # durée de la partie séquentielle
Tp = {p: chrono(programme, p, repetitions=2) for p in P}
f = t_s / Tp[1]
print(f"partie séquentielle : {t_s:.2f} s sur {Tp[1]:.2f} s   donc f = {f:.2f}")
Résultat →
partie séquentielle : 0.40 s sur 2.38 s donc f = 0.17Cellule 14
print(" p   S mesurée   S Amdahl")
for p in P:
    print(f"{p:2d}   {Tp[1] / Tp[p]:8.2f}   {amdahl(f, p):8.2f}")
Résultat →
 p   S mesurée   S Amdahl
 1       1.00       1.00
 2       1.84       1.71
Cellule 15
pp = list(range(1, 17))
plt.figure(figsize=(5.5, 3.5))
plt.plot(pp, [amdahl(f, p) for p in pp], "-", label=f"Amdahl, f = {f:.2f}")
plt.plot(P, [Tp[1] / Tp[p] for p in P], "o", label="mesuré")
plt.axhline(1 / f, ls=":", color="gray", label=f"limite 1/f = {1 / f:.1f}")
plt.xlabel("nombre de processus p"); plt.ylabel("accélération S(p)")
plt.title("La partie séquentielle plafonne le gain"); plt.legend(); plt.show()
Résultat →
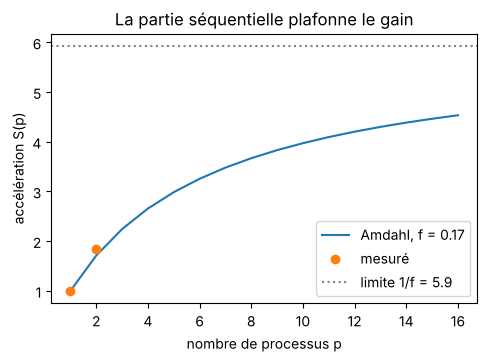
Les points mesurés suivent la courbe d’Amdahl, un peu en dessous (le démarrage des processus s’ajoute à la partie séquentielle). La courbe s’aplatit sous la limite \(1/f\) : même avec seize cœurs, le programme ne peut pas aller plus de \(1/f\) fois plus vite, parce que sa partie séquentielle dure toujours autant.
Diviser la partie séquentielle par quatre (calcul(2_500_000) dans programme et dans la mesure de t_s). Que deviennent \(f\) et la limite \(1/f\) ?
Cellule 16 — à compléter
# refaire les deux cellules avec calcul(2_500_000)Partie 5 — Mini-projet : calculer \(\pi\) par Monte-Carlo
On tire des points au hasard dans un carré de côté \(1\). La part de points qui tombent dans le quart de disque de rayon \(1\) vaut environ \(\pi/4\) (aire du quart de disque divisée par l’aire du carré). Chaque point est indépendant des autres : on donne à chaque processus son lot de points, avec sa propre graine, puis on additionne les points tombés dedans.
Cellule 17
def pi_monte_carlo(n_total, p):
    n = n_total // p
    with mp.Pool(p) as pool:
        dedans = pool.starmap(monte_carlo, [(n, graine) for graine in range(p)])
    return 4 * sum(dedans) / (n * p)

for p in P:
    t0 = time.perf_counter()
    estimation = pi_monte_carlo(4_000_000, p)
    print(f"p = {p} : pi ~ {estimation:.5f}  (erreur {abs(estimation - math.pi):.5f})"
          f"  en {time.perf_counter() - t0:.2f} s")
Résultat →
p = 1 : pi ~ 3.14128  (erreur 0.00031)  en 0.59 s
p = 2 : pi ~ 3.14184 (erreur 0.00025) en 0.30 sChaque estimation est proche de \(3{,}1416\), et la durée diminue avec \(p\). Les estimations diffèrent un peu d’un \(p\) à l’autre, parce que les points tirés ne sont pas les mêmes (chaque processus a sa graine). La graine rend le calcul reproductible : relancer la cellule redonne exactement les mêmes nombres.
Avec \(p = 2\), estimer \(\pi\) avec \(40\,000\), \(400\,000\) et \(4\,000\,000\) points. L’erreur diminue-t-elle à chaque fois ? En moyenne, multiplier le nombre de points par \(100\) divise l’erreur par \(10\) : le hasard peut faire mentir une seule mesure.
Cellule 18 — à compléter
# for n in (40_000, 400_000, 4_000_000): ...Ce qu’il faut retenir
Pool.map,starmapetapply_asyncconfient des tâches à plusieurs processus ; la fonction vient d’un module.- L’accélération mesurée reste sous l’idéal : démarrer les processus et transmettre les données coûte du temps.
- Une tâche doit durer beaucoup plus que son envoi ; sinon le parallélisme ralentit (granularité,
chunksize). - Des tâches de durées inégales se répartissent mieux en petits morceaux pris au fur et à mesure.
- La partie séquentielle plafonne le gain à \(1/f\) (loi d’Amdahl), quel que soit le nombre de cœurs.
Lab suivant : la mémoire, ce que chaque processus copie, ce qu’ils partagent, et ce que cela coûte.
Pour cette séance
Le cours
Les slides
À lire en ligne
- TD — Séance 1 — Fondements de l’architecture parallèle
- Lab 0 — Prise en main : Anaconda, Jupyter et les outils Python des labs (énoncé)
- Lab 0 — Prise en main : Anaconda, Jupyter et les outils Python des labs
- Lab 1 — Penser parallèle : map, reduce et tâches indépendantes (énoncé)
- Lab 1 — Penser parallèle : map, reduce et tâches indépendantes
- Lab 2 — Plusieurs cœurs : multiprocessing, granularité et loi d’Amdahl
À télécharger
- Lab 0 — Prise en main : Anaconda, Jupyter et les outils Python des labs
Télécharger le notebook (.ipynb, 80 Ko) - Lab 1 — Penser parallèle : map, reduce et tâches indépendantes
Télécharger le notebook (.ipynb, 68 Ko) - Lab 2 — Plusieurs cœurs : multiprocessing, granularité et loi d’Amdahl
Télécharger le notebook (.ipynb, 110 Ko) - Notebooks des labs de la séance 1 (ZIP, 147 Ko)