Les Labs 3 et 4 ont partagé des données entre processus et entre fils d’une même machine.
Télécharger le notebookLes sorties sont celles enregistrées dans le notebook : rien n'est réexécuté.
Mémoire distribuée et NUMA : placement, répertoire et messages
Dr. El Hadji Bassirou TOURÉ · DMI · FST · UCAD
Les Labs 3 et 4 ont partagé des données entre processus et entre fils d’une même machine. Ce lab passe à l’échelle des nœuds (Séance 4) : ce que coûte un accès selon l’endroit où se trouve la donnée, où le système place les pages d’un tableau, comment un répertoire garde les copies cohérentes sans diffusion, et comment calculer avec des processus qui ne partagent rien et n’échangent que des messages.
Un portable n’a qu’un nœud NUMA : les coûts entre nœuds se simulent avec les latences d’un serveur à quatre nœuds ; ce qui se mesure sur toutes les machines (localité dans les caches, placement des pages au premier contact, messages entre processus) se mesure pour de vrai.
Prérequis : Labs 2 à 4. Durée estimée : 1 h 30.
Partie 0 — Mise en place
Les fonctions confiées aux processus sont dans le module outils_lab5.py, écrit par la cellule suivante.
%%writefile outils_lab5.pyimport osimport numpy as npdef lier_au_coeur(i):"""lie le processus courant à un coeur (Linux seulement ; ailleurs, ne fait rien)"""ifhasattr(os, "sched_setaffinity"): coeurs =sorted(os.sched_getaffinity(0)) os.sched_setaffinity(0, {coeurs[i %len(coeurs)]})def somme_creee(i, m, q):"""processus i : crée SA partition de m valeurs, envoie (i, somme) dans la file q""" lier_au_coeur(i) part = np.random.default_rng(i).random(m) # les pages sont touchées ici q.put((i, float(part.sum()))) # message : deux nombresdef somme_recue(part):"""reçoit une partition entière (copiée depuis le parent) et rend sa somme"""returnfloat(part.sum())def modifier_liste(liste, q): liste.append("modifié par l'enfant") # modifie SA copie de la liste q.put(len(liste))def stats_station(graine, n):"""températures (°C) d'une station : n mesures ; à compléter dans le mini-défi""" t =24+6* np.random.default_rng(graine).standard_normal(n)returnNone
Writing outils_lab5.py
import os, sys, time, globimport numpy as npimport multiprocessing as mpimport matplotlib.pyplot as pltimport outils_lab5 as o5def chrono(f, *args, repetitions=3):"""exécute f(*args) plusieurs fois et rend la durée la plus courte, en secondes""" meilleure =float("inf")for _ inrange(repetitions): t0 = time.perf_counter() f(*args) meilleure =min(meilleure, time.perf_counter() - t0)return meilleureprint("coeurs :", os.cpu_count(), " système :", sys.platform)noeuds =sorted(glob.glob("/sys/devices/system/node/node[0-9]*"))for d in noeuds: # Linux : un dossier par noeudprint(os.path.basename(d), ": coeurs", open(d +"/cpulist").read().strip()," distances", open(d +"/distance").read().strip())ifnot noeuds:print("topologie NUMA non disponible sur ce système")
coeurs : 2   système : linux
node0 : coeurs 0-1   distances 10
Lecture. Un portable affiche un seul nœud (node0, distance 10), ou rien sous Windows et macOS. Un serveur bi-socket afficherait node0 et node1 et les distances 10 21 : c’est sur ce genre de machine que les parties 1 et 2 prennent tout leur sens.
Partie 1 — Coût local et distant
1.1 Un serveur à quatre nœuds, simulé
Les quatre nœuds sont reliés en anneau : N0–N1, N1–N3, N3–N2, N2–N0. Un accès coûte \(90\) ns dans la mémoire locale, \(135\) ns chez un voisin (1 saut) et \(190\) ns chez le nœud opposé (2 sauts). DIST[a][b] est la latence d’un accès du nœud a vers la mémoire du nœud b.
LOCAL, UN_SAUT, DEUX_SAUTS =90, 135, 190SAUTS = [[0, 1, 1, 2], # N0 : voisin de N1 et N2, opposé à N3 [1, 0, 2, 1], [1, 2, 0, 1], [2, 1, 1, 0]]DIST = [[(LOCAL, UN_SAUT, DEUX_SAUTS)[s] for s in ligne] for ligne in SAUTS]def latence_moyenne(parts):"""parts : liste de (fraction des accès, latence en ns) ; moyenne pondérée"""assertabs(sum(f for f, _ in parts) -1) <1e-9returnsum(f * lat for f, lat in parts)for ligne in DIST:print(ligne)L1 = latence_moyenne([(0.5, LOCAL), (0.3, UN_SAUT), (0.2, DEUX_SAUTS)])print(f"50 % local, 30 % à 1 saut, 20 % à 2 sauts : {L1:.1f} ns")print(f"en cycles à 3 GHz : {L1 *3:.0f} cycles d'attente par accès")
[90, 135, 135, 190]
[135, 90, 190, 135]
[135, 190, 90, 135]
[190, 135, 135, 90]
50 % local, 30 % à 1 saut, 20 % à 2 sauts : 123.5 ns
en cycles à 3 GHz : 370 cycles d'attente par accès
Lecture. La latence moyenne est une moyenne pondérée : \(0{,}5\times90+0{,}3\times135+0{,}2\times190 =
123{,}5\) ns, soit \(1{,}37\) fois un accès local. À \(3\) GHz, le cœur attend plus de \(370\) cycles par accès.
À faire. Un nouveau placement rend \(80\) % des accès locaux et laisse le reste à 1 saut. Calculer la nouvelle latence moyenne, l’accélération par rapport à \(123{,}5\) ns et la baisse du temps en pourcentage.
# L2 = latence_moyenne([...])
1.2 La localité, mesurée
Une machine à un seul nœud ne montre pas l’écart entre local et distant, mais elle montre déjà qu’une donnée loin dans la hiérarchie coûte cher. Le même travail lit le même tableau, dans l’ordre puis au hasard ; les lectures data[indices] ont lieu pendant la mesure.
def parcours(data, indices):return np.sum(data[indices] **2) # lit data dans l'ordre des indicesprint(" taille ordre (ms) hasard (ms) rapport")rapports = {}for n in [50_000, 500_000, 5_000_000]: data = np.random.default_rng(0).random(n) ordre = np.arange(n) hasard = np.random.default_rng(1).permutation(n) t_o = chrono(parcours, data, ordre, repetitions=5) t_h = chrono(parcours, data, hasard, repetitions=5) rapports[n] = t_h / t_oprint(f"{n:>11,}{t_o *1e3:11.2f}{t_h *1e3:13.2f}{t_h / t_o:9.1f}")
Lecture.\(50\,000\) valeurs (\(0{,}4\) Mo) tiennent dans les caches (sur la machine de mesure : \(2\) Mio de L2 par cœur, \(260\) Mio de L3) : l’ordre importe peu. Au-delà, chaque lecture au hasard tombe dans une autre ligne de cache : elle coûte ici environ deux fois plus, et bien davantage sur une machine dont le L3 est plus petit que le tableau. Sur un serveur NUMA, la commande numactl --cpunodebind=0 --membind=1 python3 script.py ferait en plus payer la distance à la mémoire d’un autre nœud.
À faire. Sur \(10\) millions de valeurs, comparer la durée de data.sum() (toutes les valeurs) et de data[::8].sum() (une valeur sur \(8\), soit une par ligne de cache de \(64\) octets). Le second calcul lit \(8\) fois moins de valeurs : est-il \(8\) fois plus rapide ? Qu’en conclure sur l’unité de transfert entre la mémoire et le cache ?
# data = np.random.default_rng(0).random(10_000_000) ...
Partie 2 — Placement des pages et premier contact
2.1 Une page n’est placée qu’au premier contact
Le système réserve les adresses d’un tableau sans lui donner de mémoire physique ; une page reçoit sa mémoire (et donc son nœud) quand elle est touchée pour la première fois. Sous Linux, la mémoire physique d’un processus se lit dans /proc/self/status (ligne VmRSS).
def memoire_physique_mio():"""mémoire physique utilisée par ce processus (Linux), en Mio ; None ailleurs"""ifnot os.path.exists("/proc/self/status"):returnNonefor ligne inopen("/proc/self/status"):if ligne.startswith("VmRSS"):returnint(ligne.split()[1]) /1024avant = memoire_physique_mio()grand = np.empty(25_000_000) # 200 Mo réservésapres_empty = memoire_physique_mio()grand[:] =1.0# premier contact : toutes les pagesapres_ecriture = memoire_physique_mio()if avant isNone:print("mesure non disponible sur ce système (Linux seulement)")else:print(f"avant : {avant:.0f} Mio après np.empty : {apres_empty:.0f} Mio"f" après écriture : {apres_ecriture:.0f} Mio")del grand
avant : 209 Mio après np.empty : 209 Mio après écriture : 400 Mio
Lecture.np.empty ne change presque pas la mémoire physique : les \(200\) Mo (\(191\) Mio) sont seulement réservés. L’écriture ajoute environ \(191\) Mio : c’est à ce moment que chaque page est placée, sur le nœud du cœur qui écrit. Sur un serveur NUMA, le fil qui initialise un tableau décide donc où il vit.
2.2 Trois placements, simulés
Un tableau de \(24\) pages est lu par quatre fils, un par nœud : le fil f lit le quart contigu 6f à 6f + 5.
def placer(n_pages, politique):"""noeud de chaque page selon la politique de placement"""if politique =="fil principal": # tout initialisé par un fil de N0return [0] * n_pagesif politique =="entrelacé": # numactl --interleave=allreturn [p %4for p inrange(n_pages)]if politique =="premier contact": # chaque fil initialise son quartreturn [p // (n_pages //4) for p inrange(n_pages)]def latences_fils(pages): q =len(pages) //4return [float(np.mean([DIST[f][pages[p]] for p inrange(f * q, (f +1) * q)]))for f inrange(4)]for pol in ["fil principal", "entrelacé", "premier contact"]: pages = placer(24, pol) lat = latences_fils(pages)print(f"{pol:16s} pages par noeud {np.bincount(pages, minlength=4)}"f" fils {[round(x, 1) for x in lat]} moyenne {np.mean(lat):.2f} ns")
fil principal    pages par noeud [24  0  0  0]   fils [90.0, 135.0, 135.0, 190.0]   moyenne 137.50 ns
entrelacé        pages par noeud [6 6 6 6]   fils [129.2, 145.8, 145.8, 129.2]   moyenne 137.50 ns
premier contact  pages par noeud [6 6 6 6]   fils [90.0, 90.0, 90.0, 90.0]   moyenne 90.00 ns
Lecture. Si le fil principal initialise tout, les fils 1 et 2 lisent à 1 saut et le fil 3 à 2 sauts : moyenne \(137{,}5\) ns. L’entrelacement donne la même moyenne mais répartit les pages, donc le travail des contrôleurs mémoire, sur les quatre nœuds. Le premier contact par le fil qui calcule rend tous les accès locaux : \(90\) ns.
À faire. Écrire la politique "deux noeuds" : la moitié basse du tableau initialisée par un fil de N0, la moitié haute par un fil de N3. Calculer la latence de chaque fil et la moyenne. Pourquoi les fils 1 et 2 ne gagnent-ils rien ?
# pages = [...] # noeud de chaque page# print(latences_fils(pages))
Partie 3 — Un répertoire, simulé opération par opération
La classe suivante joue le protocole du cours pour un bloc X : état du répertoire (U, S, M), vecteur de présence, état MSI de chaque cache. Chaque message coûte tr ns, chaque accès mémoire du home tm ns. La lecture est fournie ; l’écriture est à compléter.
class Repertoire:def__init__(self, p, home, tr, tm):self.p, self.home, self.tr, self.tm = p, home, tr, tmself.etat ="U"self.presence = [0] * pself.caches = ["I"] * pdef lire(self, n):"""rend (cas, nombre de messages, latence en ns)"""ifself.caches[n] in ("S", "M"):return"succès", 0, 0ifself.etat in ("U", "S"): # cas 1 : bloc propre cas, msg, lat ="lecture propre", 2, 2*self.tr +self.tmelse: # cas 2 : bloc modifié proprio =self.presence.index(1)self.caches[proprio] ="S"# write-back, M -> S cas, msg, lat ="lecture modifié", 4, 4*self.tr +self.tmself.etat ="S"self.presence[n] =1self.caches[n] ="S"return cas, msg, latdef ecrire(self, n):raiseNotImplementedError("à compléter (À faire ci-dessous)")def afficher(self, op, res): bits ="".join(map(str, self.presence))print(f"{op:14s}{res[0]:18s}{res[1]:2d} msg {res[2]:4d} ns "f"rep. {self.etat}{bits} caches {''.join(self.caches)}")R = Repertoire(p=4, home=1, tr=45, tm=85)for n in (0, 3, 0): R.afficher(f"N{n} lit X", R.lire(n))
N0 lit X       lecture propre      2 msg  175 ns   rep. S 1000   caches SIII
N3 lit X       lecture propre      2 msg  175 ns   rep. S 1001   caches SIIS
N0 lit X       succès              0 msg    0 ns   rep. S 1001   caches SIIS
Lecture. N0 lit : bloc en U, propre, \(2\) messages, \(2\times45+85=175\) ns ; le répertoire passe en S avec le bit de N0. N3 lit : même cas, son bit s’ajoute (1001). La seconde lecture de N0 est un succès dans son cache : aucun message.
À faire. Écrire la méthode ecrire(self, n) pour le cas d’une écriture sur un bloc en U ou en S (cas 3 du cours) : elle invalide les copies des autres nœuds dont le bit vaut 1, met le demandeur seul propriétaire (état M) et rend ("écriture", 2 + 2k, latence) avec \(k\) copies invalidées ; latence \(2t_r+\max(t_m, 2t_r)\) si \(k \geq 1\) (invalidations en parallèle pendant la lecture mémoire), \(2t_r+t_m\) si aucune copie n’est à invalider. Pour un bloc déjà en M chez un autre nœud, rendre ("écriture modifié", 4, 4 * tr) : requête, Fetch au propriétaire, données renvoyées au home, réponse ; la mémoire n’est pas réécrite. Puis exécuter la cellule de test.
def ecrire(self, n):# à compléter : succès si le cache de n est déjà en M ;# sinon, invalider les autres copies, mettre à jour etat,# presence et caches, et rendre (cas, messages, latence)raiseNotImplementedError("à compléter")Repertoire.ecrire = ecrire
# Test : ne pas modifiertrace = [("L", 0), ("L", 3), ("L", 2), ("E", 2), ("L", 0), ("E", 3), ("L", 3), ("E", 1)]R = Repertoire(p=4, home=1, tr=45, tm=85)total =0try:for op, n in trace: res = R.lire(n) if op =="L"else R.ecrire(n) R.afficher(f"N{n}{'lit'if op =='L'else'écrit'} X", res) total += res[1] ok = total ==26and R.etat =="M"and R.presence == [0, 1, 0, 0]print("total des messages :", total)print("respecté : la trace complète"if ok else"à corriger : la trace") R2 = Repertoire(p=4, home=1, tr=45, tm=85) ok2 = R2.ecrire(2) == ("écriture", 2, 175) # bloc en U : aucune copieprint("respecté : écriture sur un bloc en U"if ok2else"à corriger : écriture sur un bloc en U") ok3 = res == ("écriture modifié", 4, 180) # dernière opération de la traceprint("respecté : écriture sur un bloc modifié ailleurs"if ok3else"à corriger : écriture sur un bloc modifié ailleurs")exceptNotImplementedError:print("à corriger : la méthode ecrire n'est pas encore écrite")
N0 lit X       lecture propre      2 msg  175 ns   rep. S 1000   caches SIII
N3 lit X       lecture propre      2 msg  175 ns   rep. S 1001   caches SIIS
N2 lit X       lecture propre      2 msg  175 ns   rep. S 1011   caches SISS
à corriger : la méthode ecrire n'est pas encore écrite
Lecture. Avec la méthode complétée : N2 écrit un bloc que N0 et N3 ont aussi en copie : \(k=2\), \(6\) messages, \(2\times45+\max(85, 90)=180\) ns. N0 lit ensuite un bloc modifié (cas 2) : \(4\) messages, \(4\times45+85=265\) ns. N3 écrit le bloc partagé par N0 et N2 : \(6\) messages. La lecture de N3 est un succès. N1 écrit enfin un bloc modifié chez N3 : \(4\) messages, \(4\times45=180\) ns, sans écriture en mémoire. Total : \(26\) messages. Sur un bloc en U, l’écriture coûte \(2\) messages et \(2\times45+85=175\) ns.
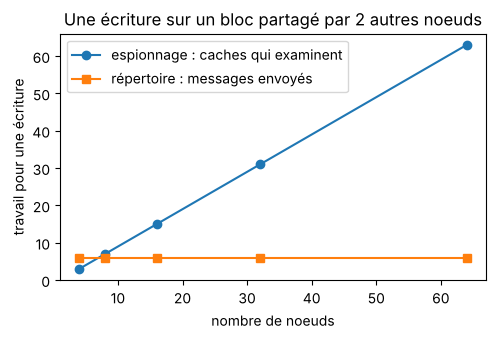
# Le même nombre d'invalidations, vu par l'espionnage : une écriture sur un bloc# partagé par k = 2 autres noeuds, pour des machines de plus en plus grandesP = [4, 8, 16, 32, 64]espion = [p -1for p in P] # la transaction atteint tous les autres cachesrepert = [2+2*2for p in P] # requête, 2 invalidations, 2 accusés, réponseplt.figure(figsize=(5.5, 3.2))plt.plot(P, espion, "o-", label="espionnage : caches qui examinent")plt.plot(P, repert, "s-", label="répertoire : messages envoyés")plt.xlabel("nombre de noeuds"); plt.ylabel("travail pour une écriture")plt.title("Une écriture sur un bloc partagé par 2 autres noeuds")plt.legend()plt.show()
Lecture. Le travail de l’espionnage croît avec le nombre de nœuds ; celui du répertoire ne dépend que du nombre de copies. C’est la raison du passage au répertoire au-delà de 8 à 16 cœurs.
Partie 4 — Calcul distribué : messages et réduction
4.1 Des processus qui ne partagent rien
Un processus enfant reçoit une copie des données ; ce qu’il modifie ne revient au parent que par un message.
liste = ["donnée du parent"]q = mp.Queue()enfant = mp.Process(target=o5.modifier_liste, args=(liste, q))enfant.start()taille_vue_par_l_enfant = q.get() # message envoyé par l'enfantenfant.join()print("l'enfant voit", taille_vue_par_l_enfant, "éléments ; le parent voit", liste)
l'enfant voit 2 éléments ; le parent voit ['donnée du parent']
Lecture. Le fils a ajouté un élément à sa liste (il en voit deux) ; la liste du parent n’a pas changé. Le seul moyen de transmettre un résultat est l’envoi explicite (q.put, puis q.get chez le parent) : c’est le modèle de la mémoire distribuée.
4.2 Une réduction distribuée
Somme de \(8\) millions de valeurs sur \(p\) processus, de deux façons : (A) chaque processus crée sa partition et n’envoie que sa somme ; (B) le parent crée tout le tableau et envoie une partition à chaque processus.
N =8_000_000def somme_A(p): q = mp.Queue() ps = [mp.Process(target=o5.somme_creee, args=(i, N // p, q)) for i inrange(p)]for pr in ps: pr.start() recus =dict(q.get() for _ in ps) # p messages de deux nombresfor pr in ps: pr.join()returnsum(recus[i] for i inrange(p))def somme_B(p, data):with mp.Pool(p) as pool:returnsum(pool.map(o5.somme_recue, np.array_split(data, p)))p =min(2, os.cpu_count())ref =sum(float(np.random.default_rng(i).random(N // p).sum()) for i inrange(p))data = np.concatenate([np.random.default_rng(i).random(N // p) for i inrange(p)])t0 = time.perf_counter()sA = somme_A(p)tA = time.perf_counter() - t0t0 = time.perf_counter()sB = somme_B(p, data)tB = time.perf_counter() - t0print(f"A (créer sur place) : {sA:.3f} en {tA:.2f} s identique : {sA == ref}")print(f"B (envoyer les données) : {sB:.3f} en {tB:.2f} s écart : {abs(sB - ref):.1e}")print(f"octets envoyés : A {p *16} B {data.nbytes:,}")
A (créer sur place)      : 3999965.441 en 0.04 s   identique : True
B (envoyer les données) : 3999965.441 en 0.21 s   écart : 0.0e+00
octets envoyés : A 32   B 64,000,000
Lecture. Les deux sommes coïncident (à l’arrondi près pour B, qui additionne dans un autre ordre). A n’échange que \(p\) messages de \(16\) octets ; B copie \(64\) Mo vers les processus, en plus de les avoir créés dans le parent. C’est la règle des algorithmes conscients de NUMA : créer les données là où elles sont calculées, ne faire circuler que les résultats, puis faire la réduction finale. Sous Windows et macOS (mode spawn), le démarrage d’un processus (import de NumPy) domine : l’écart entre A et B se réduit.
À faire. Refaire la mesure de somme_A et somme_B avec \(p = 1\), puis \(p = 4\) (même sur deux cœurs). Que deviennent les durées ? Pourquoi somme_A reste-t-elle correcte quel que soit \(p\) ?
# for p in (1, 4): ...
Mini-défi — La température moyenne de six stations
Six stations météo (Dakar, Thiès, Kaolack, Saint-Louis, Ziguinchor, Tambacounda) enregistrent chacune \(500\,000\) mesures, simulées par la graine de la station. Compléter stats_station dans outils_lab5.py (Partie 0) pour qu’elle rende un message court : (somme, nombre de mesures, maximum), puis réexécuter la cellule de la Partie 0 ; la cellule de test relit le module. Le parent combine les six messages en une moyenne et un maximum globaux. La cellule de test vérifie le résultat contre le calcul séquentiel et la taille des messages.
# Test : ne pas modifierimport importlibo5 = importlib.reload(o5) # relire outils_lab5.py après modificationSTATIONS = ["Dakar", "Thies", "Kaolack", "Saint-Louis", "Ziguinchor", "Tambacounda"]n =500_000with mp.Pool(min(6, os.cpu_count())) as pool: messages = pool.starmap(o5.stats_station, [(g, n) for g inrange(len(STATIONS))])ifany(m isNonefor m in messages):print("à corriger : stats_station rend None")else: moyenne =sum(m[0] for m in messages) /sum(m[1] for m in messages) maximum =max(m[2] for m in messages) tout = np.concatenate([24+6* np.random.default_rng(g).standard_normal(n)for g inrange(len(STATIONS))])print(f"moyenne {moyenne:.4f} °C maximum {maximum:.2f} °C")for nom, ok in [("moyenne exacte", abs(moyenne - tout.mean()) <1e-9), ("maximum exact", maximum == tout.max()), ("messages de 3 nombres", all(len(m) ==3for m in messages))]:print(("respecté : "if ok else"à corriger : ") + nom)
à corriger : stats_station rend None
Pour finir. Combien d’octets les six messages représentent-ils, comparés aux \(3\) millions de mesures (\(24\) Mo) ? Pourquoi faut-il envoyer la somme et le nombre de mesures, plutôt que la moyenne de chaque station, quand les stations n’ont pas le même nombre de mesures ?
Ce qu’il faut retenir
En NUMA, la latence moyenne est une moyenne pondérée par la part des accès locaux, à 1 saut, à 2 sauts.
Une page n’est placée qu’à son premier contact : le fil qui initialise un tableau décide où il vit.
L’entrelacement répartit la charge entre les nœuds ; le premier contact par le fil qui calcule rend les accès locaux.
Un répertoire n’envoie des invalidations qu’aux nœuds qui ont une copie : \(2 + 2k\) messages, quel que soit le nombre de nœuds.
Des processus ne partagent pas leur mémoire : un résultat passe par un message.
Une réduction distribuée crée les données là où elles sont calculées et ne fait circuler que les résultats.